Latar Belakang Permasalahan
Media sosial menjadi salah satu ruang utama bagi masyarakat untuk menyampaikan pandangan mengenai isu publik, termasuk Pemilu Indonesia. Percakapan yang muncul dapat memuat dukungan, kritik, maupun respons netral terhadap proses pemilu dan berbagai isu yang menyertainya.
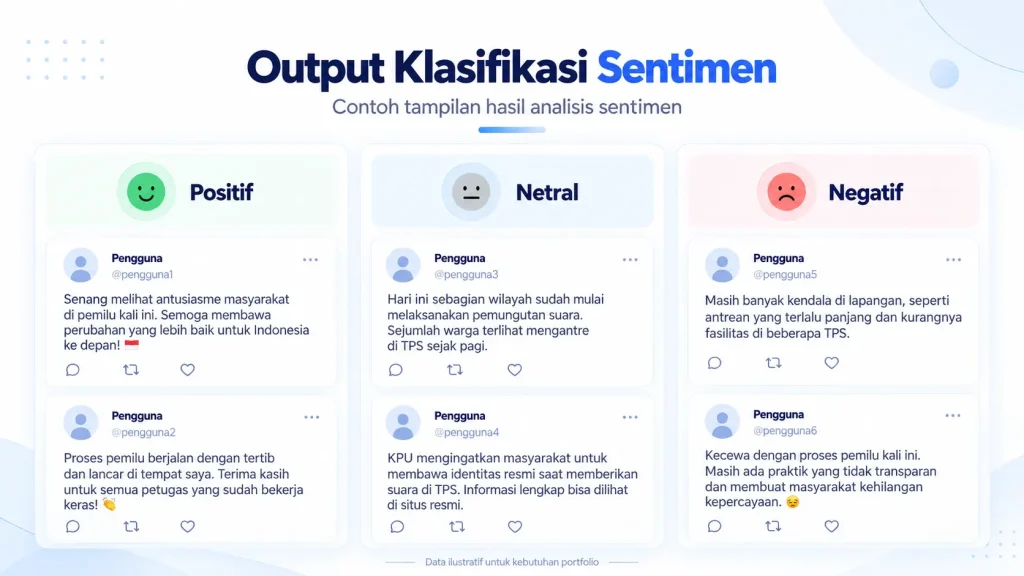
Besarnya volume percakapan membuat opini publik sulit dianalisis secara manual. Dibutuhkan pendekatan yang dapat mengolah teks dalam jumlah besar dan mengelompokkan opini secara sistematis berdasarkan kecenderungan sentimennya. Dalam proyek ini, sentimen dirancang untuk diklasifikasikan menjadi positif, negatif, dan netral, sehingga pola opini dalam dataset dapat dipahami secara lebih terstruktur.
Solusi dan Pendekatan
Kami merancang proses sentiment analysis berbasis machine learning dengan membandingkan dua algoritma klasifikasi, yaitu Naïve Bayes Classifier dan Support Vector Machine (SVM).
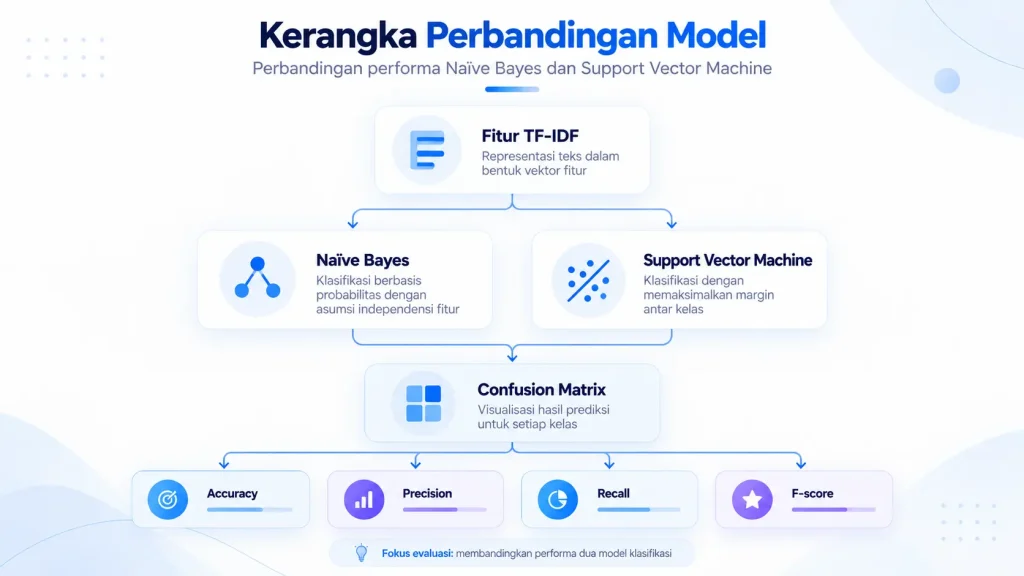
Kedua model digunakan untuk mempelajari pola dari data tweet yang telah diberikan label, kemudian melakukan prediksi kelas sentimen pada data lainnya. Fokus evaluasi bukan hanya menghasilkan klasifikasi, tetapi juga membandingkan performa kedua algoritma untuk mengetahui model yang memberikan hasil klasifikasi lebih baik pada dataset penelitian.
Sebelum proses klasifikasi, teks diolah melalui preprocessing dan kemudian dikonversi menjadi representasi numerik menggunakan Term Frequency–Inverse Document Frequency (TF-IDF). Pendekatan ini memungkinkan kata-kata dalam tweet diproses sebagai fitur yang dapat digunakan oleh model machine learning.
Proses Pengerjaan
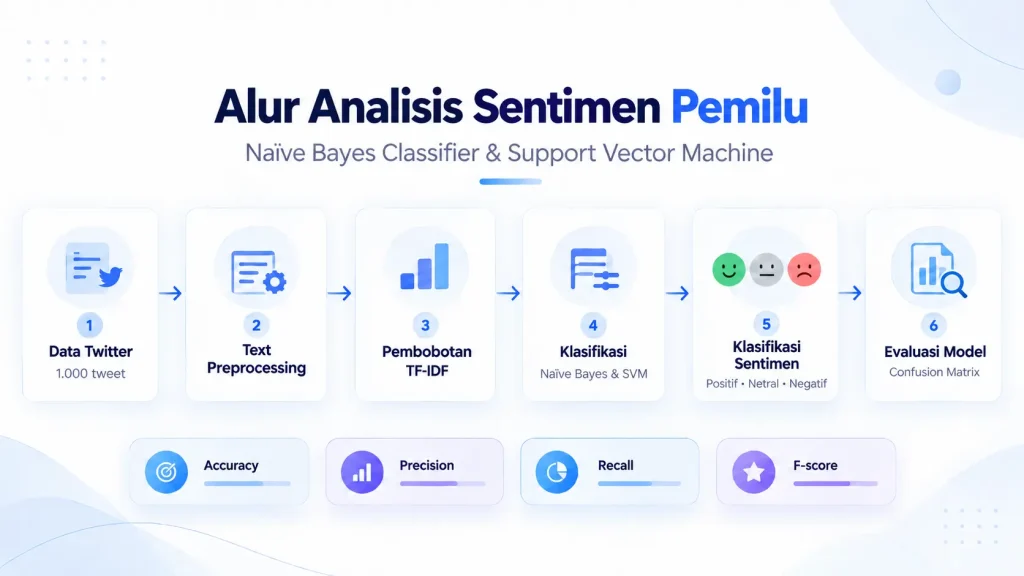
Pengerjaan dirancang dalam tiga kelompok tahapan, yaitu tahap awal, tahap pengembangan, dan tahap akhir. Tahap awal mencakup studi literatur serta pengumpulan data, dilanjutkan dengan pemrosesan teks, pembobotan kata, klasifikasi, evaluasi, dan analisis hasil.
Dataset yang direncanakan terdiri dari 1.000 tweet mengenai Pemilu. Pengumpulan data menggunakan beberapa kata kunci dan tagar yang berkaitan dengan topik pemilu, kemudian data disimpan dalam format CSV untuk memasuki tahap pengolahan.
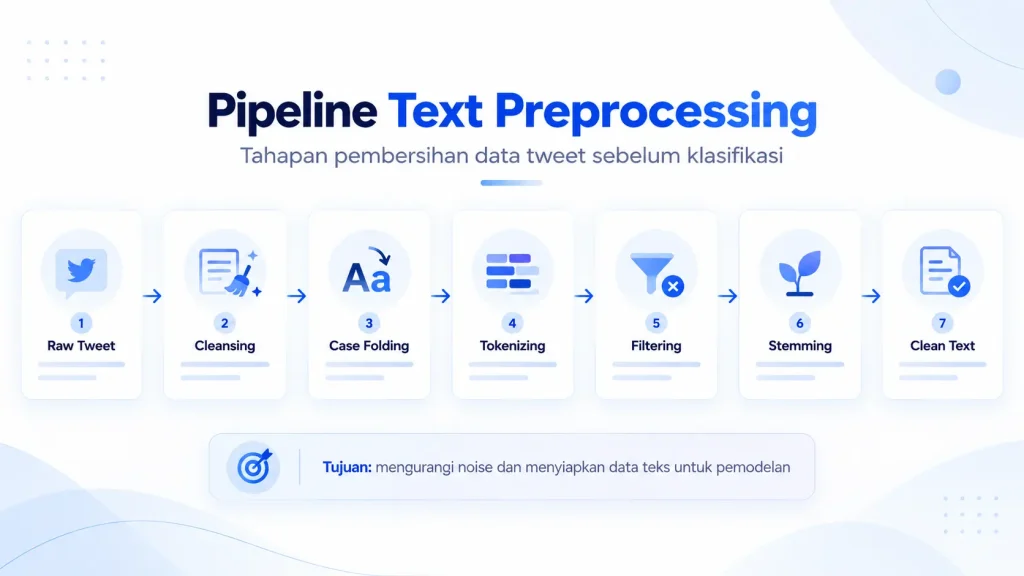
Data teks yang masih tidak terstruktur kemudian melalui proses preprocessing. Tahapan tersebut mencakup cleansing, case folding, tokenizing, filtering, dan stemming. Tujuannya adalah mengurangi noise serta menghasilkan representasi teks yang lebih bersih sebelum digunakan dalam pemodelan.
Setelah proses pembersihan, kumpulan kata diubah menjadi bentuk numerik menggunakan TF-IDF. Data tersebut selanjutnya digunakan untuk membangun model Naïve Bayes dan SVM. Model yang terbentuk dirancang untuk mengklasifikasikan tweet menjadi kategori sentimen positif, negatif, atau netral.
Output yang Dirancang
Proyek ini dirancang untuk menghasilkan dua output utama. Pertama, model klasifikasi yang mampu mengelompokkan opini menjadi sentimen positif, negatif, dan netral. Kedua, hasil perbandingan performa antara Naïve Bayes Classifier dan Support Vector Machine.
Evaluasi kedua model dirancang menggunakan confusion matrix dengan empat metrik utama, yaitu accuracy, precision, recall, dan F-score. Hasil pengujian kemudian dianalisis secara deskriptif untuk mengetahui perbedaan performa kedua pendekatan klasifikasi.