
Latar Belakang Permasalahan
Sebuah peristiwa publik yang mendapat perhatian luas di media sosial menghasilkan banyak komentar dengan opini yang beragam. Banyaknya data teks tersebut membuat proses identifikasi tanggapan masyarakat secara manual menjadi kurang efisien, terutama ketika komentar harus dikelompokkan berdasarkan sentimen positif, negatif, dan netral.
Penelitian kemudian diarahkan untuk menerapkan analisis sentimen berbasis machine learning sehingga opini masyarakat dapat diklasifikasikan secara lebih sistematis. Dua algoritma digunakan dalam penelitian, yaitu K-Nearest Neighbour (KNN) dan Support Vector Machine (SVM).
Solusi dan Pendekatan
Pendekatan yang digunakan adalah pengolahan data teks melalui metode text mining. Data media sosial dipersiapkan terlebih dahulu melalui proses preprocessing sebelum diubah menjadi representasi numerik menggunakan pembobotan Term Frequency–Inverse Document Frequency (TF-IDF).
Data yang telah diproses kemudian digunakan untuk membangun model klasifikasi menggunakan KNN dan SVM. Kedua model digunakan untuk memprediksi kategori sentimen pada data yang belum memiliki label sehingga setiap opini dapat dikelompokkan menjadi sentimen positif, negatif, atau netral.
Proses Pengerjaan
Proses penelitian dimulai dari pengumpulan dataset media sosial dan dilanjutkan dengan penyiapan data sebelum masuk ke tahap pemodelan. Preprocessing mencakup case folding, cleaning, tokenizing, stopword removal, stemming, dan normalization.
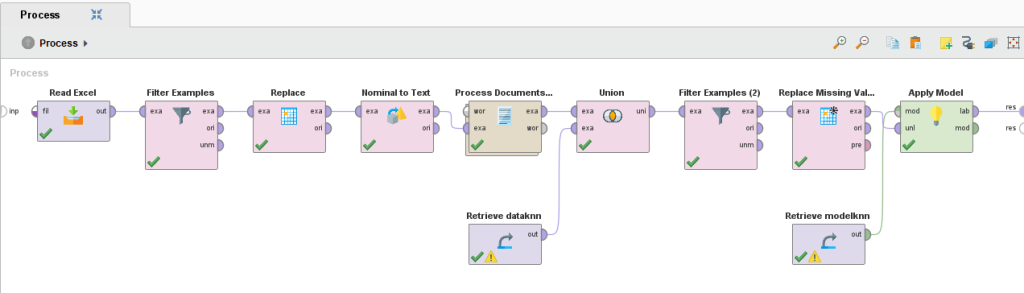
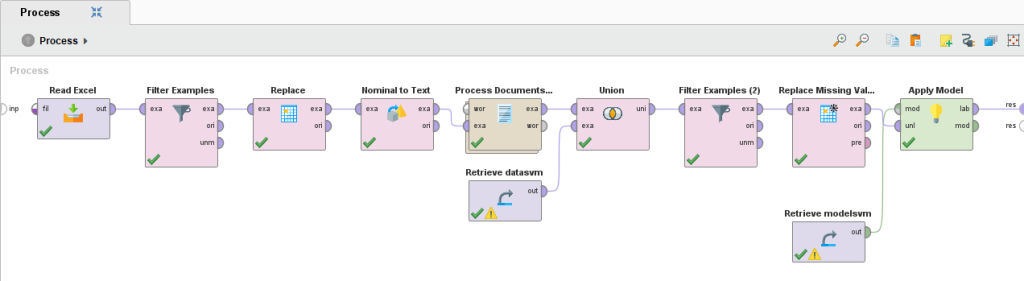
Setelah preprocessing, sebagian data digunakan sebagai training data untuk membangun model, sedangkan data lainnya digunakan sebagai testing data. Dalam pengujian akhir, model KNN dan SVM digunakan untuk memprediksi sentimen pada 700 data testing. Implementasi model dilakukan melalui RapidMiner.
Hasil yang Dicapai
Model yang dibangun berhasil mengklasifikasikan data testing ke dalam tiga kategori sentimen. Pada pengujian menggunakan KNN, dari 700 data diperoleh 397 sentimen negatif, 285 sentimen positif, dan 18 sentimen netral.
Pengujian menggunakan SVM terhadap jumlah data yang sama menghasilkan 316 sentimen negatif, 276 sentimen positif, dan 108 sentimen netral. Dengan demikian, kedua algoritma mampu menghasilkan klasifikasi sentimen, tetapi dengan distribusi prediksi yang berbeda
| Sentimen | KNN | SVM |
|---|---|---|
| Positif | 285 | 276 |
| Negatif | 397 | 316 |
| Netral | 18 | 108 |